
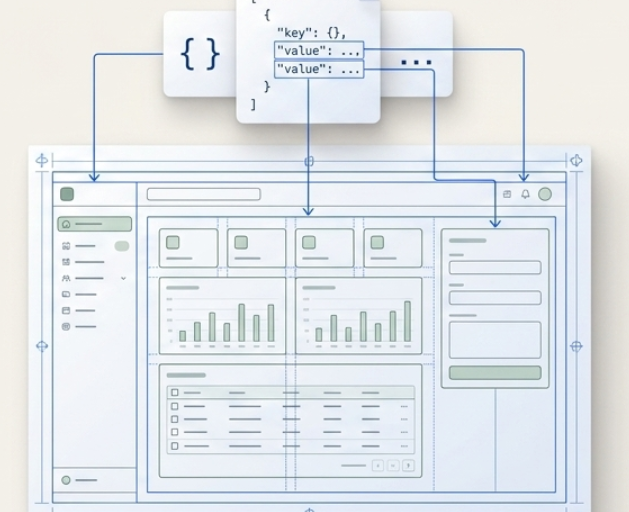
在前端,我們越來越常把 LLM 當成「介面設計師」:使用者說一句話,畫面就要長出來。這種由模型動態產出介面的做法,被稱為生成式 UI(Generative UI)。它與傳統 chatbot 最大的不同在於:輸出的目標不再只是文字,而是「可渲染的結構」。
1. 什麼是生成式 UI
生成式 UI(Generative UI)指的是:介面不是(或不全由)工程師事先寫死每一種組合,而是由模型依使用者意圖動態產出 UI 描述,再由前端確定性的程式渲染成畫面。
你可能已經用過類似能力,只是沒有掛這個名詞:
- Cursor Canvas:在 IDE 裡除了聊天串流文字,還能在對話旁開一塊即時 React 畫布。模型產出的是可編譯、可預覽的介面(例如圖表、表格、互動分析),讓「答案」變成可操作的畫面,而不是塞在 markdown 程式碼區裡。
- Claude 的 Artifacts/視覺化輸出:在網頁版 Claude 對話旁,模型可以把 HTML、React、SVG 等產物放在獨立面板裡預覽、複製或迭代——同樣是 chat 負責理解需求,另一側負責長 UI 的分工。
這類產品多半讓模型直接產出可執行的 UI 程式,再靠執行環境與沙箱把風險壓住。
和一般 chatbot 的最大差別在於:輸出目標不是純文字,而是可渲染的結構。
2. 為什麼需要生成式 UI
傳統前端開發有一個長期痛點:畫面的組合幾乎是無限的。
產品經理今天要一個「依條件顯示不同欄位的表單」,明天又要「根據使用者角色動態調整按鈕與說明文字」。工程師如果要把所有可能都事先寫死,程式碼會迅速膨脹;如果完全不做,使用者又只能反覆跟 AI 文字對話,效率有限。
生成式 UI 試圖解決的,正是這個落差:
- 讓「答案」本身變成可操作的介面,而不只是一段文字或 markdown。
- 降低為長尾、臨時性需求預先寫死畫面的成本。
- 讓非工程背景的使用者,也能透過自然語言得到相對客製化的操作介面。
但這條路並非沒有代價。直接讓模型吐出任意 JSX 或 HTML,很快就會遇到幻覺、樣式不一致,甚至安全問題。因此實務上,我們通常不會把「生成介面」等同於「讓 AI 自由寫前端」,而是會在模型能說的話與實際渲染之間,畫出清楚的邊界。
3. 生成式 UI 常見的三種模式
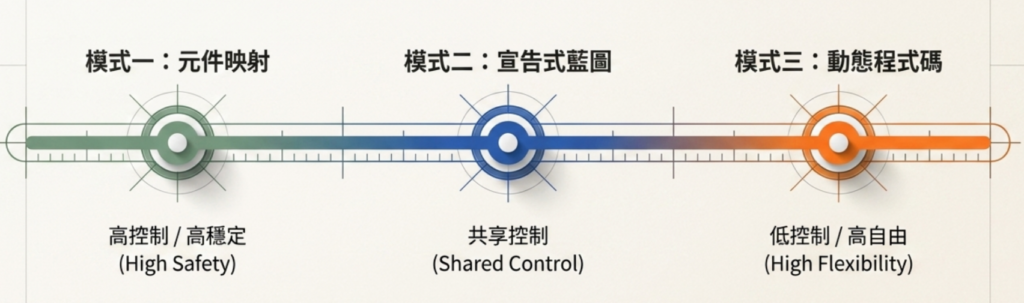
實務上常這樣分(也常混用)。先理解差異,再決定 邊界 要畫在哪:
| 模式 | 模型產出什麼 | 優點 | 風險 / 成本 |
|---|---|---|---|
| A. Tool / Function Calling | 呼叫「註冊好的 UI 函式」與參數 | 和 agent 流程自然結合 | 工具設計與錯誤處理要完整 |
| B. 結構化 JSON + 渲染器 | 固定 schema 的 UI 樹 | 可控、好驗證、元件風格一致 | 要先定義元件集,表達力受 schema 限制 |
| C. 直接生成程式碼(JSX/HTML) | 原始碼字串 | 表達力最大 | 幻覺、安全、審查與執行環境成本高 |
若你要把生成式 UI 嵌進自己的產品(例如後台、表單助手、營運工具),通常會希望畫面長得像自家 design system、且格式可驗證、可審計,這時就會傾向走較窄的管道——也就是模式 B。
下文T編會以模式 B 為主線,示範一套從零開始的實作方式。
4. 實作:用結構化 JSON 打造可控的生成式 UI
範例repo:https://github.com/TonyHuang0327/gen-ui
這次實作的核心想法很簡單:
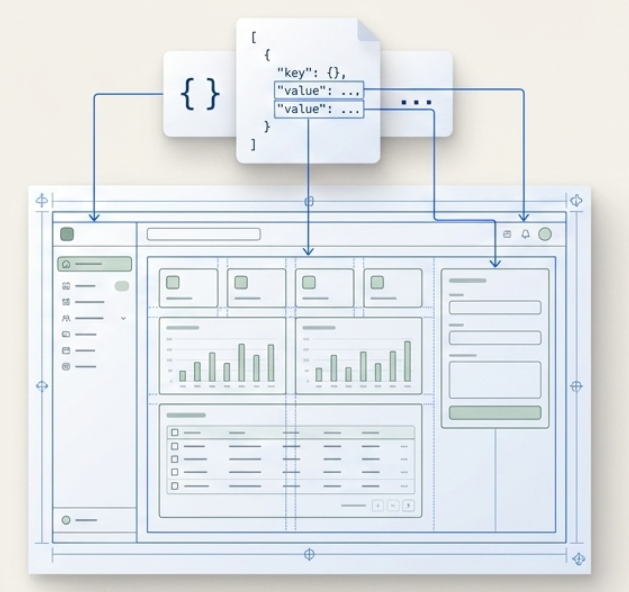
LLM 只負責產出符合約定的 JSON 樹,前端再用確定性的渲染器把它翻成你信任的元件。
模型永遠碰不到任意 DOM 或任意 React 程式碼。
技術棧可以很小:React + TypeScript + Vite、Tailwind 與 shadcn / Base UI、Zod 做 runtime 驗證、Google Gemini(結構化 JSON 輸出)。
整個流程可以拆成五塊,順序就是在畫依賴方向——模型只能在你允許的 vocabulary 裡說話:
定義元件(types)
    ↓
設計渲染器(Renderer)
    ↓
定義 LLM 回傳格式(JSON Schema)
    ↓
串接 LLM(Gemini Interactions + structured output)
    ↓
驗證 LLM response(Zod,第二道防線)
對應的模組分工大致如下:
src/
  types/           ← 元件契約(TypeScript)
  Renderer.tsx     ← JSON → React
  schema/          ← Zod 驗證
  lib/llm.ts       ← Gemini + response schema
  App.tsx          ← prompt、state、資料流
  mock-response.ts ← 無 API 時的預設 UI 樹
接下來會依序說明每一層在做什麼,以及為什麼要這樣設計。
4.1 先定義元件:縮小 LLM 的「詞彙表」
第一步不是接 API,而是回答:模型允許用哪些積木、每塊積木有什麼欄位?
export type UiNode = CustomPage | CustomButton | CustomText;

type CustomPage = {
  type: "page";
  children: UiNode[];
};

type CustomButton = {
  type: "button";
  label: string;
  variant?:
    | "default"
    | "outline"
    | "ghost"
    | "destructive"
    | "secondary"
    | "link";
};

type CustomText = {
  type: "text";
  text: string;
};
範例裡只有 page / button / text,刻意 小。之後每加一種元件,都是 產品與安全邊界的決策,不只是多寫一個 switch case。
4.2 設計渲染器:唯一允許「長 UI」的地方
Renderer 是中介層——接收 node,轉成你審過的 React 元件:
export const Renderer = ({ node }: { node: UiNode }) => {
  switch (node.type) {
    case "page":
      return (
        <div>
          {node.children.map((child, index) => (
            <Renderer key={index} node={child} />
          ))}
        </div>
      );
    case "button":
      return <Button variant={node.variant}>{node.label}</Button>;
    case "text":
      return <p>{node.text}</p>;
  }
};
LLM 不 import 你的 design system;只有 Renderer 可以。
將來加 input、card,改 Renderer(以及 types、Zod、LLM 的 JSON Schema)即可,不必在 prompt 裡堆 HTML 規則。
4.3 定義 LLM 回傳格式:請 Gemini 只吐 JSON
在 lib/llm.ts 用 JSON Schema 綁 response_format,讓 API 層就約束輸出形狀。
一個務實簡化:根節點一定是 page,children 裡先只允許 button / text(不在送給模型的 schema 裡嵌套 page),降低模型搞錯巢狀結構的機率;Zod 端仍可保留遞迴 page,方便之後擴充對齊。
const uiJsonSchema = {
  type: "object",
  properties: {
    type: { type: "string", enum: ["page"] },
    children: {
      type: "array",
      items: {
        anyOf: [
          {
            type: "object",
            properties: {
              type: { type: "string", enum: ["button"] },
              label: { type: "string" },
              variant: {
                type: "string",
                enum: [
                  "default",
                  "outline",
                  "ghost",
                  "destructive",
                  "secondary",
                  "link",
                ],
              },
            },
            required: ["type", "label"],
          },
          {
            type: "object",
            properties: {
              type: { type: "string", enum: ["text"] },
              text: { type: "string" },
            },
            required: ["type", "text"],
          },
        ],
      },
    },
  },
  required: ["type", "children"],
} as const;
串接 Gemini(Interactions API + structured JSON):
import { GoogleGenAI } from "@google/genai";

export async function generateUiTree(prompt: string): Promise<unknown> {
  const apiKey = import.meta.env.VITE_GEMINI_API_KEY;
  if (!apiKey) {
    throw new Error("缺少 VITE_GEMINI_API_KEY");
  }

  const client = new GoogleGenAI({ apiKey });

  const interaction = await client.interactions.create({
    model: "gemini-3.6-flash",
    input: [
      {
        type: "text",
        text: `你是 UI JSON 產生器。只輸出符合 schema 的 JSON,不要 markdown。
使用者需求:${prompt}`,
      },
    ],
    response_format: {
      type: "text",
      mime_type: "application/json",
      schema: uiJsonSchema,
    },
  });

  const text = interaction.output_text;
  if (!text) {
    throw new Error("模型沒有回傳文字");
  }

  return JSON.parse(text);
}
本地開發需在環境變數設定 VITE_GEMINI_API_KEY。正式環境不建議把 key 放在 VITE_* 。
4.4 多加一層 Zod:為什麼 API schema 夠了還要驗證?
API 的 JSON Schema ≠ 前端型別安全的終點。
模型行為、SDK 版本、或手動替換的 mock 資料,都可能讓 runtime 出現「長得像 JSON 但不是合法 UI 樹」的物件。
用 z.lazy + discriminatedUnion("type") 對齊 UiNode:
import z from "zod";

const uiNodeSchema: z.ZodType<UiNode> = z.lazy(() =>
  z.discriminatedUnion("type", [
    z.object({ type: z.literal("page"), children: z.array(uiNodeSchema) }),
    z.object({
      type: z.literal("button"),
      label: z.string(),
      variant: z
        .enum([
          "default",
          "outline",
          "ghost",
          "destructive",
          "secondary",
          "link",
        ])
        .optional(),
    }),
    z.object({ type: z.literal("text"), text: z.string() }),
  ]),
);

export const safeParseUiNode = (node: unknown) => uiNodeSchema.safeParse(node);
頁面層在 每次渲染結果區 都應 safeParseUiNode(uiTree);使用者送出 prompt 後,也要 parse 成功才更新 state。
這是 fail closed:寧可顯示錯誤,也不要把未知 shape 丟進 Renderer。
4.5 頁面與資料流
主畫面可以分成三塊:上方 生成結果、下方 prompt 表單、初始載入用 mock UI 樹 避免空白頁。
async function handleSubmit(event: FormEvent<HTMLFormElement>) {
  event.preventDefault();
  const trimmed = prompt.trim();
  if (!trimmed) return;
  try {
    const data = await generateUiTree(trimmed);
    const parsed = safeParseUiNode(data);
    if (!parsed.success) {
      console.error(parsed.error.message);
      return;
    }
    setUiTree(parsed.data);
  } catch (error) {
    console.error(error);
  }
}

// 渲染區
{parsedResponse.success ? (
  <Renderer node={parsedResponse.data} />
) : (
  <p>Error: {parsedResponse.error.message}</p>
)}
整條鏈:
使用者輸入 prompt
    → generateUiTree(prompt)     // LLM + JSON Schema
    → safeParseUiNode(data)      // Zod
    → setUiTree(parsed.data)
    → <Renderer node={...} />      // 確定性渲染
Mock 範例長這樣(一顆 outline 按鈕 + 一段文字):
export const mockResponse: UiNode = {
  type: "page",
  children: [
    { type: "button", label: "Click me", variant: "outline" },
    { type: "text", text: "Hello, world!" },
  ],
};
5. 下一步:擴充與風險
- 擴充元素
每加一種 UiNode,通常要同步改:types → Zod → 送給模型的 JSON Schema → Renderer(必要時再加 shadcn 元件)。
- Streaming
若一次等 output_text 整包回來再 parse,使用者會覺得「卡住」。若要「元件一個個長出來」,往往要改為 stream partial JSON,或調整 schema 策略(例如先產文字區塊再產按鈕),複雜度會明顯上升。
- Prompt injection
使用者 prompt 會進模型訊息。惡意輸入可能試圖 繞過「只輸出 UI JSON」(例如在 label 裡夾帶指令)。
- 前後端分離
前端環境變數 VITE_* 會被打進 bundle,API key 不該長期放在那裡。T編認為是較合理的架構:
Browser  →  你的 API Route  →  Gemini
              ↑ key 只在 server
瀏覽器只送 prompt,後端回 已驗證的 UiNode JSON(或錯誤碼),邊界會清楚很多。
6. 結語
做完這個小 demo,T編比較有感的不是畫面有多漂亮,而是它逼設計者把 UI 拆成兩半:一半是可以交給模型生成的描述(JSON),另一半是不能妥協的渲染層(Renderer + design system)。
過程中常常會停下來想:「這個欄位到底該不該讓 LLM 決定?」後來發現,這個問題其實就是在釐清——哪些是呈現上的彈性,哪些是業務或安全上的邊界。某種程度上,這好像也反映了現在前端正在發生的變化。
AI 開始介入介面的產出,但真正決定「什麼能生成、什麼必須自己掌控」的,還是我們自己。生成式 UI 不是要取代前端,而是讓我們重新思考介面的邊界該畫在哪裡。
如果你也想試試看,T編自己的經驗是:先從很少的元件、很淺的樹、再加上基本的驗證開始就好。等資料流跑順了,再慢慢加其他的東西。
